
MA2301 - Matemáticas para la Ciencia de Datos

Semana
1

Bien entendidas, las bases de datos con las que se entrenan los modelos en Machine Learning son el resultado de un proceso aleatorio el cual puede modelarse con distintos tipos de distribuciones.
Semana
2

La correlación es una medida estadística que utiliza la frecuencia con la que dos variables se relacionan proporcionalmente con la misma constante. Pensemos por ejemplo en el número de metros cuadrados y el costo de un terreno.
Semana
3

La primera vez que se propuso utilizar una distribución de Poisson fue para calcular la frecuencia con la que se encarcelaba injustamente en Francia, tomando en cuenta el número de sentencias.
Semana
4

La Ley de los Grandes números es uno de los únicos resultados matemáticos que garantiza que una base de datos podría ser una buena aproximación a un resultado general, pensemos por ejemplo en un sondeo previo a una elección presidencial.
Semana
5

Gracias al comportamiento límite de las cadenas de markov es posible predecir cuáles serían las páginas más visitadas si navegamos aleatoriamente por aquellas páginas que contengan un texto.
Semana
6

Utilizando el algoritmo de metropolis Hastings es posible descifrar mensajes codigicados por medio de una búsqueda aleatoria a través de todas las posibles traducciones.
Semana
8

El aprendizaje supervisado es muy parecido al problema de resolver un sistema de ecuaciones lineales, en este caso las matrices formadas por la base de datos es muy similar a la de los coeficientes en un sistema de ecuaciones lineales.
Semana
9

Así como la correlación nos permite calcular las relaciones que existen entre dos columnas, es posible detectar cuando dos registros dentro de nuestra base de datos son semejantes por medio del ángulo entre nuestros vectores.
Semana
10

Una de las técnicas de compresión más conocidas es el análsiis de componentes principales el cual construye una aproximación lineal de nuestra información mediante una cantidad menor de coordenadas. Podemos pensar en la información genética de las personas.
Semana
11

Las bases de datos con una enorme cantidad de textos son muy complicadas desde el punto de vista computacional y gracias a la factorización de matrices es posible eficientar este tipo de búsquedas.
Semana
12
El concepto de auto-vector es un reflejo de las simetrías contenidas en algunas de nuestras bases de datos y en algunas ocasiones podemos utilizarlas para reducir la cantidad de cálculos.
Semana
13
Existen técnicas del álgebra lineal que permiten reducir el número de cálculos necesarios para realizar una búsqueda, este tipo de problemas son muy comunes en Big Data y utilizan métodos de reducción de la dimensión.
Semana
15
En algunas ocasiones nuestras bases de datos podrían no ser suficientemente grande para realizar una estimación con algún grado de confianza, en estos casos los tests estadísticos nos permiten medir con cierto grado de certeza la viabilidad de una hipótesis sobre la población total.
Semana
16

La inferencia bayesiana nos permite añadir hipótesis que nosotros creemos y no necesariamente están siendo observados en nuestros datos, esto nos ayuda a reducir la varianza en nuestras estimaciones, estas técnicas son muy similares a las de la regularización en machine learning.
Semana
17

Este es un problema típico de los bandidos multi-brazos en el que aparece el dilema de la exploración y la explotación, es decir en donde existe un trade-off entre obtener más observacioens y optimizar las decisioens con base en las que se han hecho.
Semana
18
Regresión bayesiana geolocalizada

La localización geográfica en la que se encuentren nuestros datos puede ser utilizada para mejorar la calidad de nuestras predicciones y por ello es importante conocer los métodos de machine learning geolocalizados.
Semana
19

Tradicionalmente las regresiones frecuentistas harán una hipótesis estática sobre los parámetros de un modelo, sin embargo en inferencia bayesiana es posible agregar priors sobre el conjunto total de los parámtros sobre los que estamos entrenando.
Semana
20

Por medio de los modelos causales introducidos por primera vezo por Judea Pearl, las computadoras pueden razonar mejor utilizando incertidumbre estadística, estos modelos además permiten el estudio causal de nuestros fenómenos.
Semana
22
Aunque parezca una técnica poco sofisticada, la programación lineal es una de las herramientas más versátiles para resolver problemas de matemáticas aplicadas, es cierto que las soluciones no resuelven todos los problemas sin embargo una amplia cantidad de problemas se pueden resolver por medio de estas técnicas.
Semana
23

Las redes neuronales profundas son uno de los modelos matemáticos más utilizados y el método de aprendizaje que normalmente se utiliza fue propuesto por Cauchy, la idea principal es optimizar siguiendo la dirección opuesta del gradiente.
Semana
24

Aunque no existe una explicación matemática satisfactoria de por qué funcionan los modelos de machine learning, utilizando el concepto de convexidad ayuda a entender algunos casos particulaes en los que sí existen teoremas de convergencia.
Semana
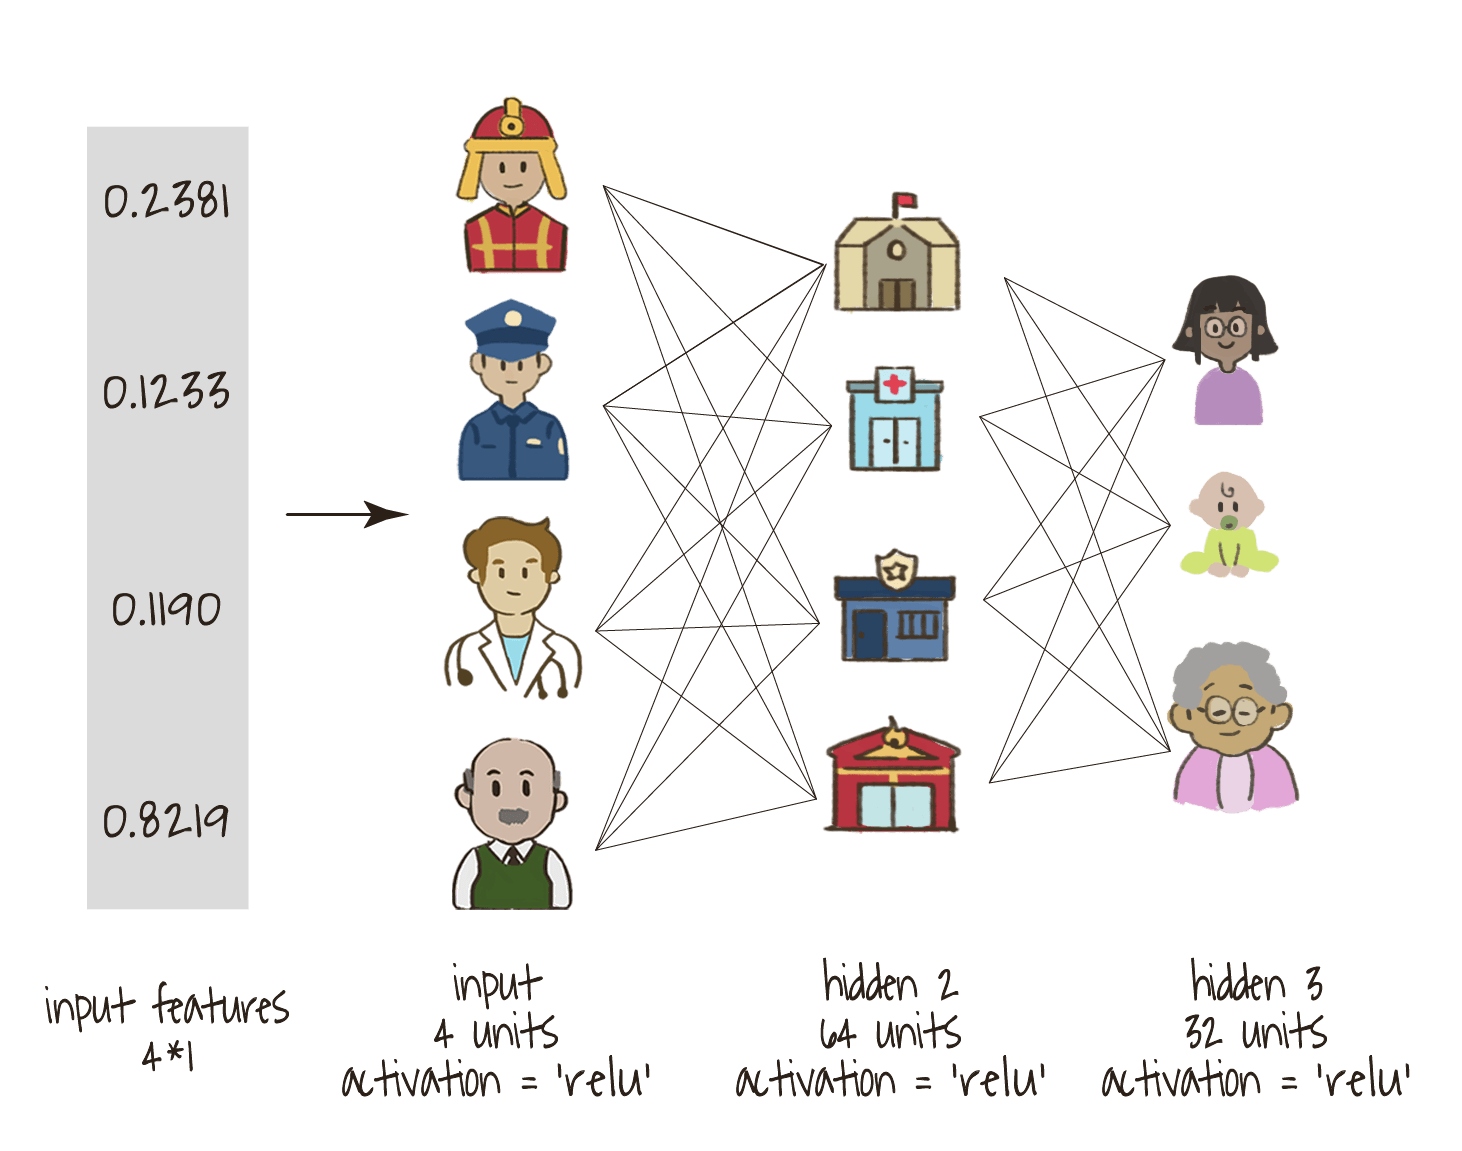
El algoritmo del gradiente descendiente sería inviable para entrenar a las redes neuronales con billones de parámetros y por ello fue necesario un algoritmo extra que permita que su entrenamiento sea viable. Este algoritmo se conoce como Back-Propagation y fue propuesto por Hinton a finales de los 90's.
Semana
26
Cuando el entrenamiento de cada una de las redes neuronales profundas definida por un hiper-parámetro distinto es muy tardado, es posible utilizar optimización bayesiana que mejore la velocidad.
Semana
27
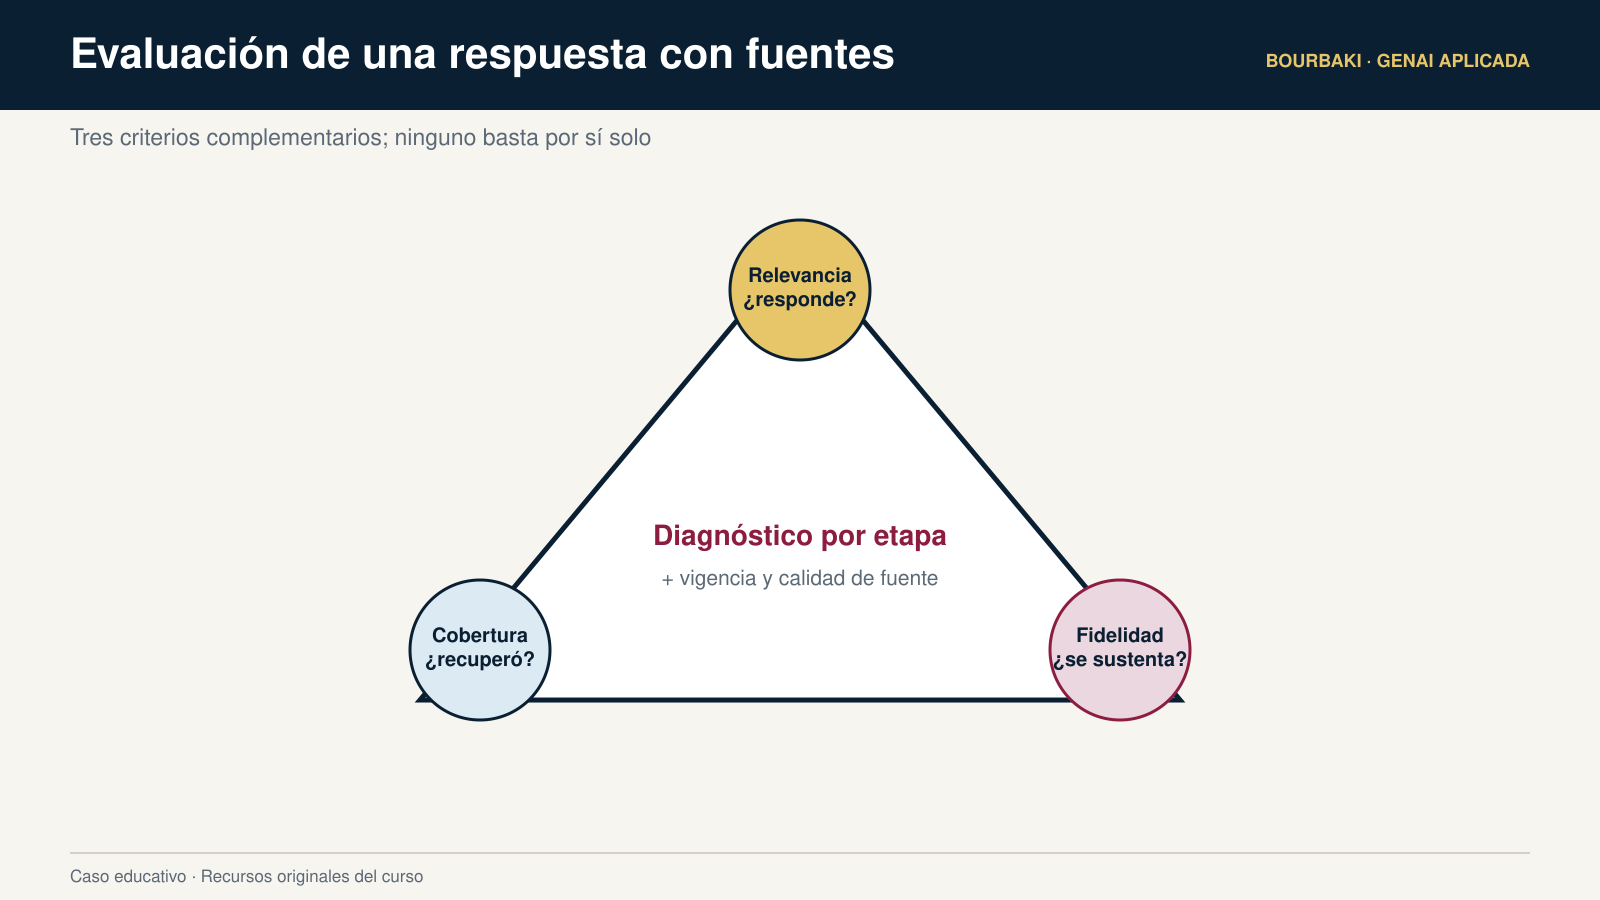
- Relevancia: la respuesta atiende directamente la pregunta.
- Fidelidad: cada afirmación está respaldada por el contexto recuperado.
- Cobertura de evidencia: el contexto contiene todas las piezas necesarias.
- Citas: las afirmaciones importantes apuntan a fragmentos concretos.
Video
V5.3. Evaluar un sistema RAG — 7 min.
Prácticas del módulo
Base de conocimiento: M05_base_conocimiento.md.
- Seleccionar hasta tres fragmentos para responder cada pregunta.
- Escribir “sin evidencia suficiente” cuando ningún fragmento contenga la respuesta.
- Comparar cortes por oración y por párrafo.
- Evaluar una respuesta con una rúbrica de relevancia, fidelidad, cobertura y citas.
Video de laboratorio
V5.4. Laboratorio en papel: consulta Nébula — 7 min.
Solución diferida: M05_solucion_rag.md.
RAG es una cadena: recuperar bien no garantiza redactar bien y una redacción convincente no compensa una fuente incompleta. Evaluar por etapas permite corregir el componente adecuado.
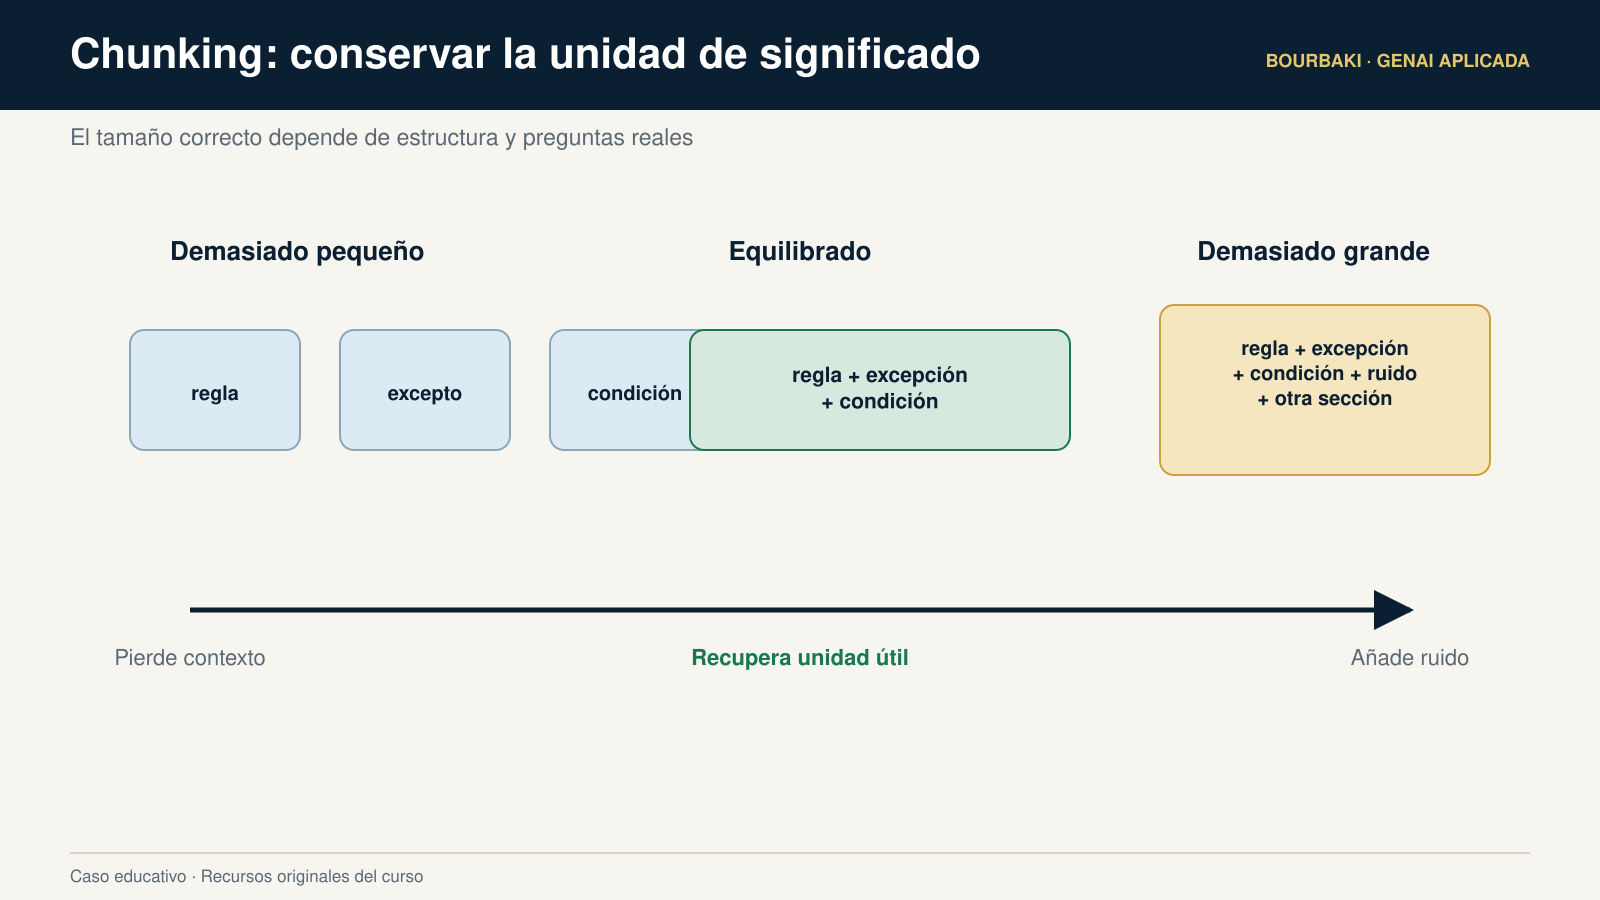
Un chunk es un fragmento recuperable. Si es demasiado corto, puede perder títulos, excepciones o relaciones. Si es demasiado largo, mezcla temas y añade ruido. El tamaño adecuado debe conservar una unidad de significado y responder al tipo de preguntas reales.
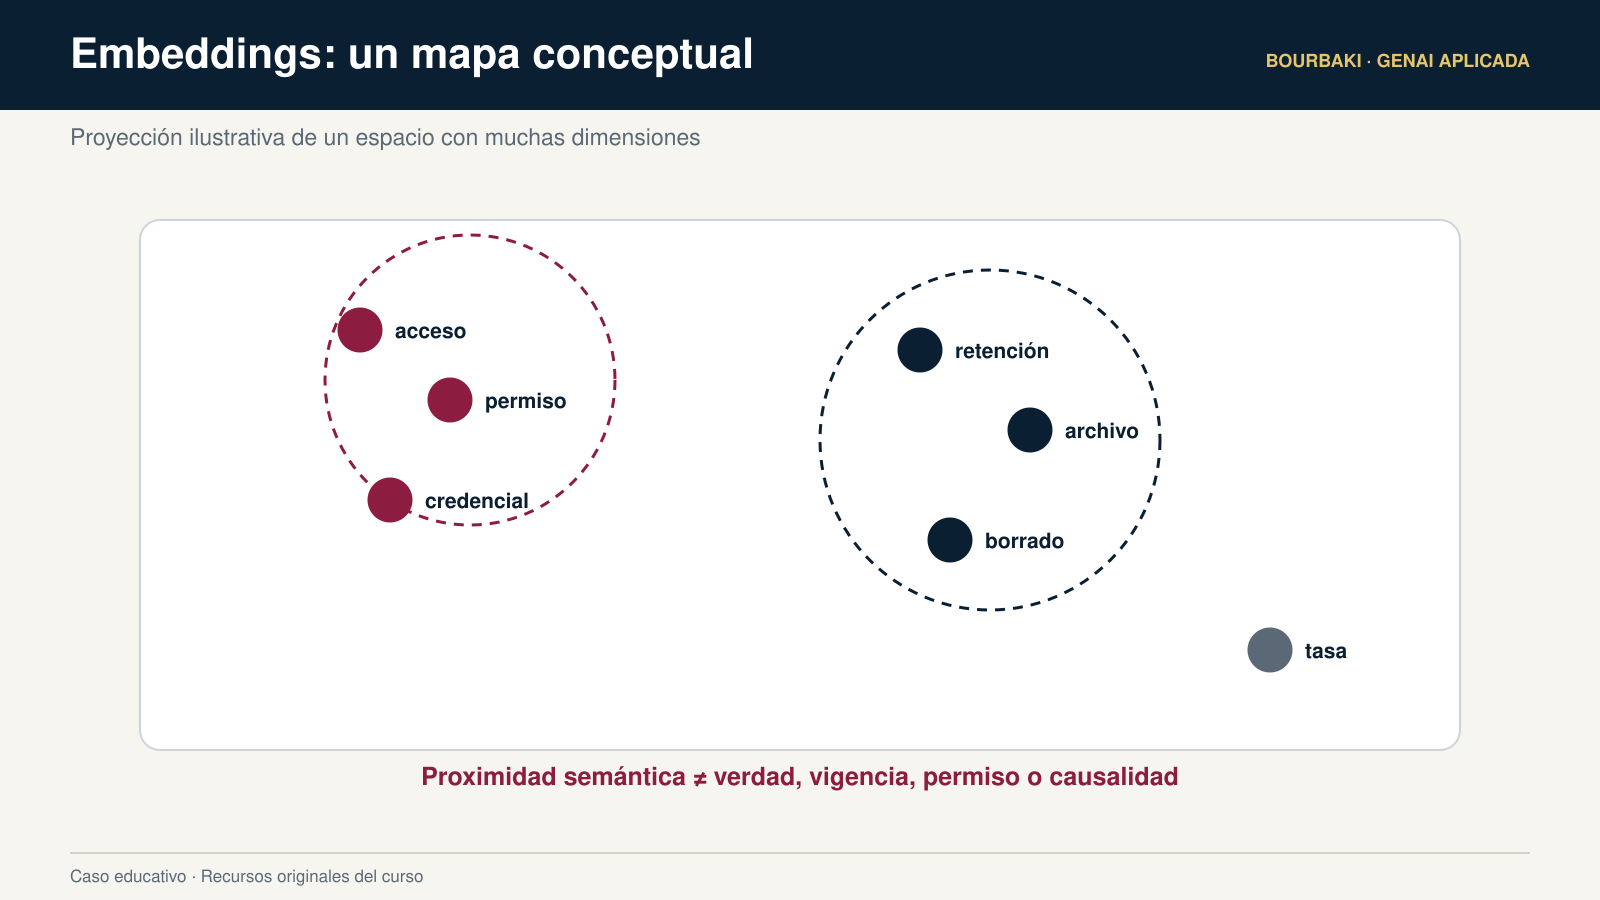
Un embedding representa el contenido mediante una lista de números que funciona como coordenadas. Los textos utilizados en contextos similares suelen quedar próximos, pero la cercanía semántica no equivale a verdad, vigencia, permiso o identidad.
Por ello, la similitud debe complementarse con metadatos como fecha, versión, región, producto, área responsable y permisos del usuario.
Video
V5.2. Fragmentos y embeddings — 8 min.
El archivista selecciona los fragmentos que llegan al contexto; el redactor produce la respuesta con ese material. Si una respuesta falla, se debe comprobar si la recuperación fue correcta, si el modelo respetó los fragmentos y si la fuente original era suficiente y vigente.
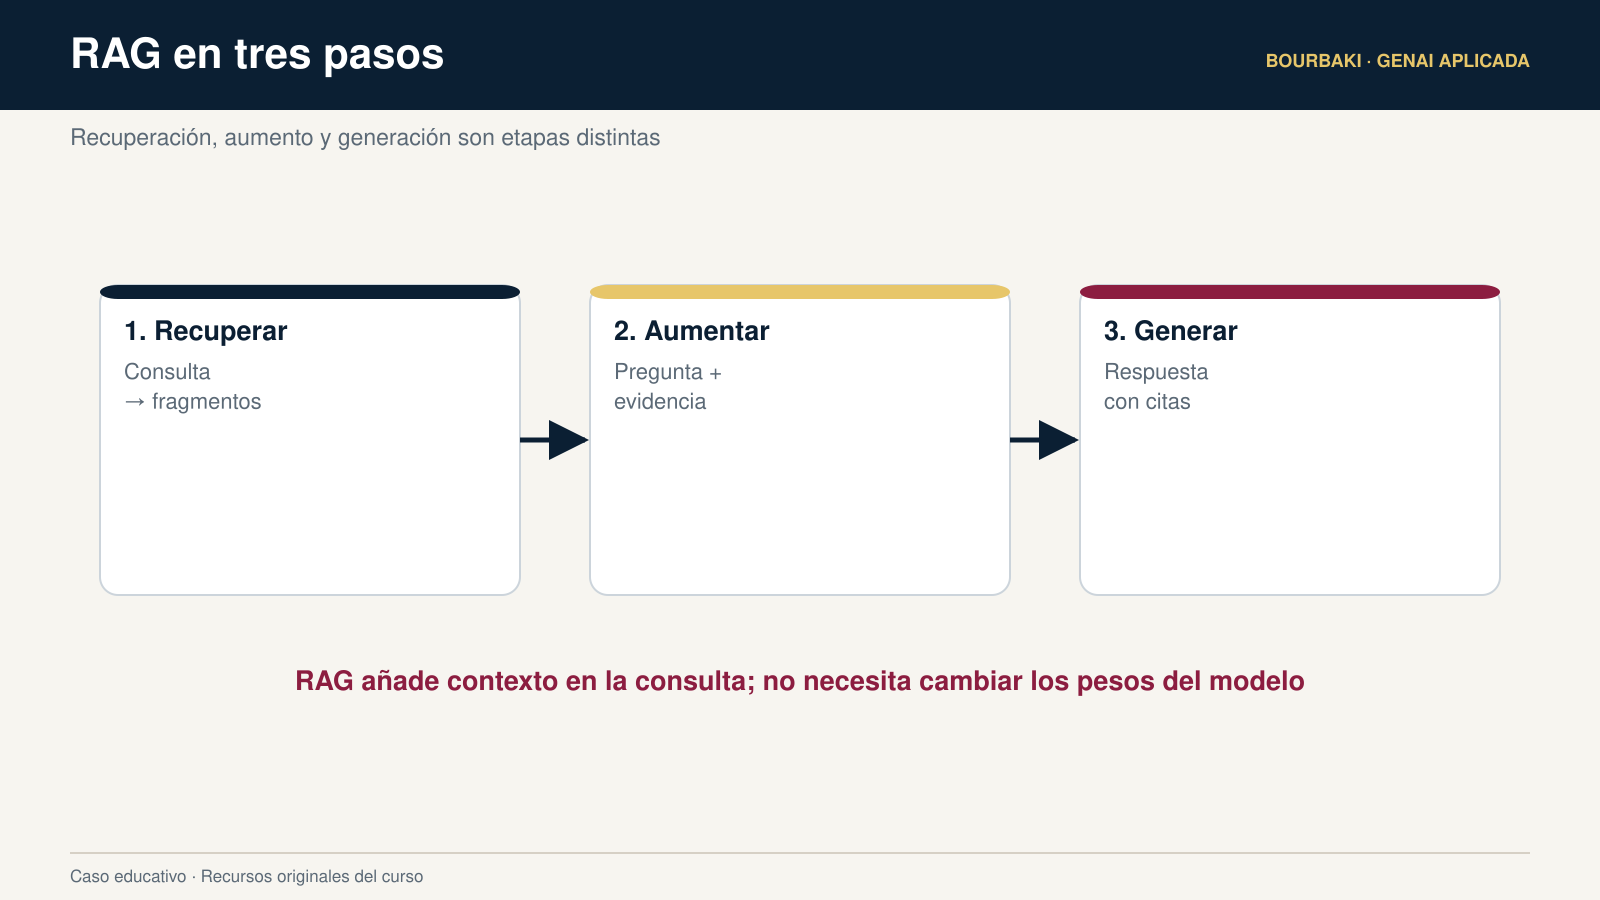
RAG significa generación aumentada por recuperación y puede entenderse mediante tres etapas:
- Recuperar: buscar fragmentos relacionados con la consulta.
- Aumentar: añadir los fragmentos relevantes al contexto de la pregunta.
- Generar: producir una respuesta basada en ese contexto y señalar las fuentes.
RAG no modifica los pesos del modelo; añade información pertinente en el momento de responder.
Video
V5.1. RAG en tres pasos — 8 min.
Antes de cargar información, identifica si contiene datos personales, financieros, laborales, legales, de salud, credenciales o secretos. Comprueba que la herramienta, la cuenta y la finalidad estén autorizadas; minimiza los datos y conserva bajo control humano cualquier decisión que afecte a una persona.
Video
V4.3. Datos, privacidad y seguridad — 7 min.
Actividad
Clasificar cinco escenarios como permitido, requiere autorización o no debe realizarse así.
Cierre para la plataforma
La confianza no proviene del tono de una respuesta. Proviene de evidencia rastreable, límites claros y una revisión proporcional al impacto.
Comprobación y transferencia
- Knowledge check de seis reactivos — 10 min.
- Registrar una afirmación que siempre deba verificarse, su fuente primaria y una decisión que deba permanecer bajo control humano.
Según la tarea, debe priorizarse el documento original, una norma, un conjunto de datos o una comunicación oficial; después, la documentación técnica, los artículos académicos, las fuentes secundarias reputadas y, finalmente, los agregadores o publicaciones sociales.
Cada cita debe abrirse y revisarse para confirmar autor, fecha, versión y fragmento de soporte.
Contenido 4.6. Privacidad, seguridad y supervisión
Antes de cargar información, identifica si contiene datos personales, financieros, laborales, legales, de salud, credenciales o secretos. Comprueba que la herramienta, la cuenta y la finalidad estén autorizadas; minimiza los datos y conserva bajo control humano cualquier decisión que afecte a una persona.
Video
V4.3. Datos, privacidad y seguridad — 7 min.
Actividad
Clasificar cinco escenarios como permitido, requiere autorización o no debe realizarse así.
Cierre para la plataforma
La confianza no proviene del tono de una respuesta. Proviene de evidencia rastreable, límites claros y una revisión proporcional al impacto.
La consulta rápida sirve para localizar un dato puntual, una definición vigente o una página oficial. La investigación profunda es adecuada cuando se deben combinar fuentes, comparar metodologías, resolver contradicciones o elaborar un informe documentado.
La profundidad no depende de la longitud de la tarea, sino de la necesidad de investigar, contrastar y sintetizar.
Video
V4.4. Investigación con fuentes — 6 min.
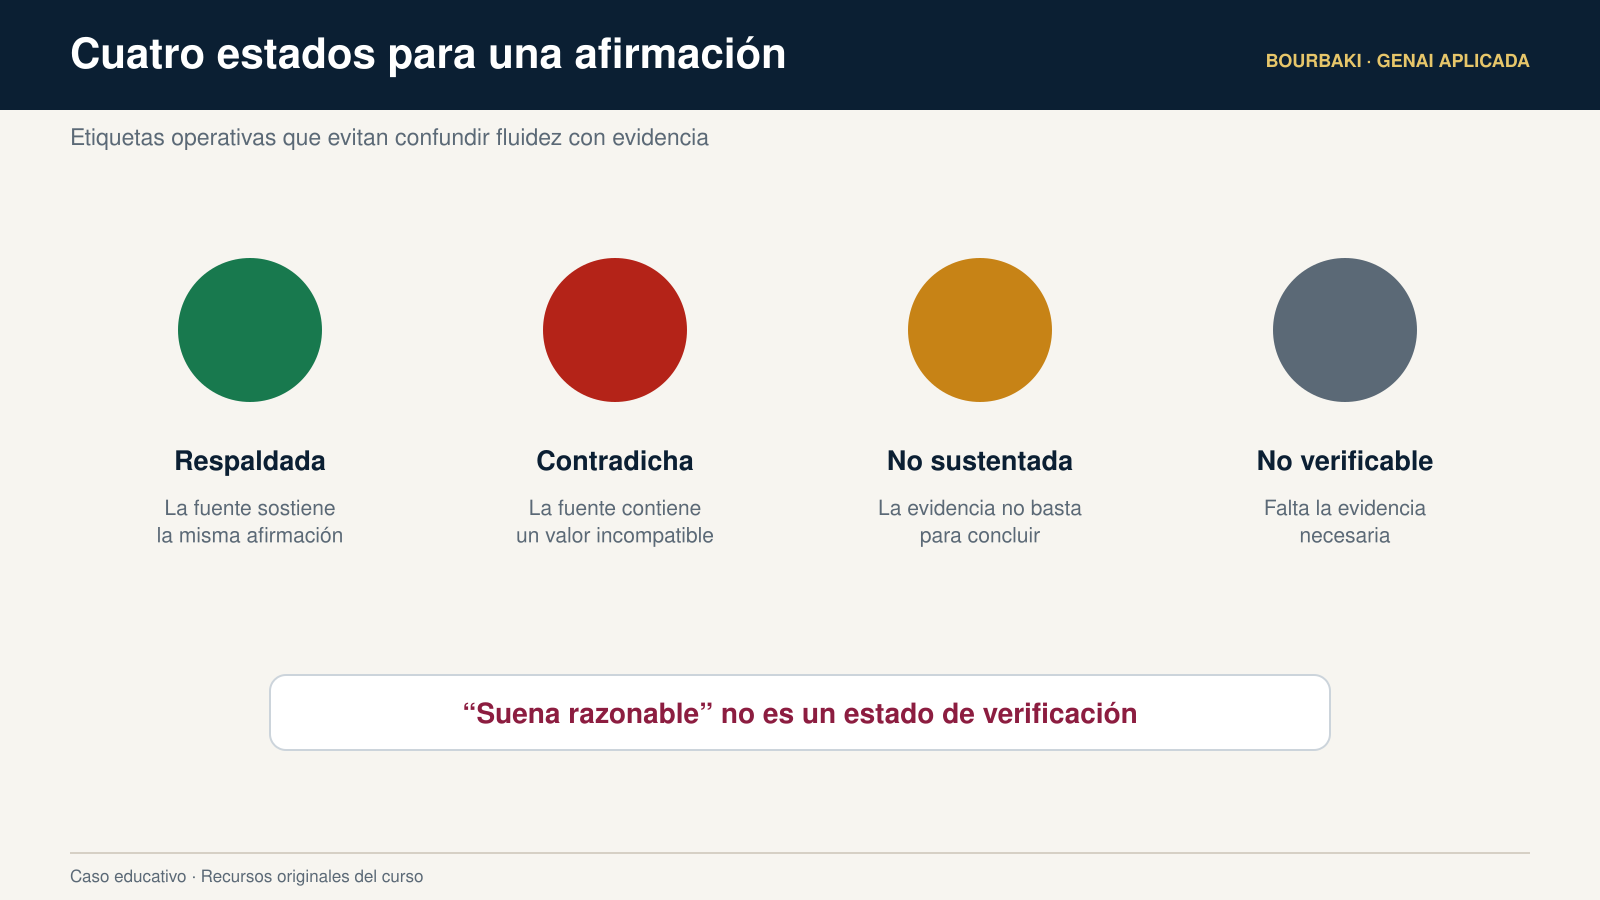
- Respaldada: la fuente contiene evidencia directa y suficiente.
- Contradicha: la fuente presenta un dato incompatible.
- No sustentada: existe información relacionada, pero no alcanza para concluir.
- No verificable: no se cuenta con la evidencia necesaria para confirmar o refutar.
No encontrar evidencia no significa automáticamente que una afirmación sea falsa.
Laboratorio
Archivos: M04_memo_generado.md y M04_paquete_evidencia.md.
Entregable: tabla con ID, Afirmación, Estado, Evidencia, Corrección propuesta y Confianza.
Solución diferida: M04_solucion_verificacion.md.
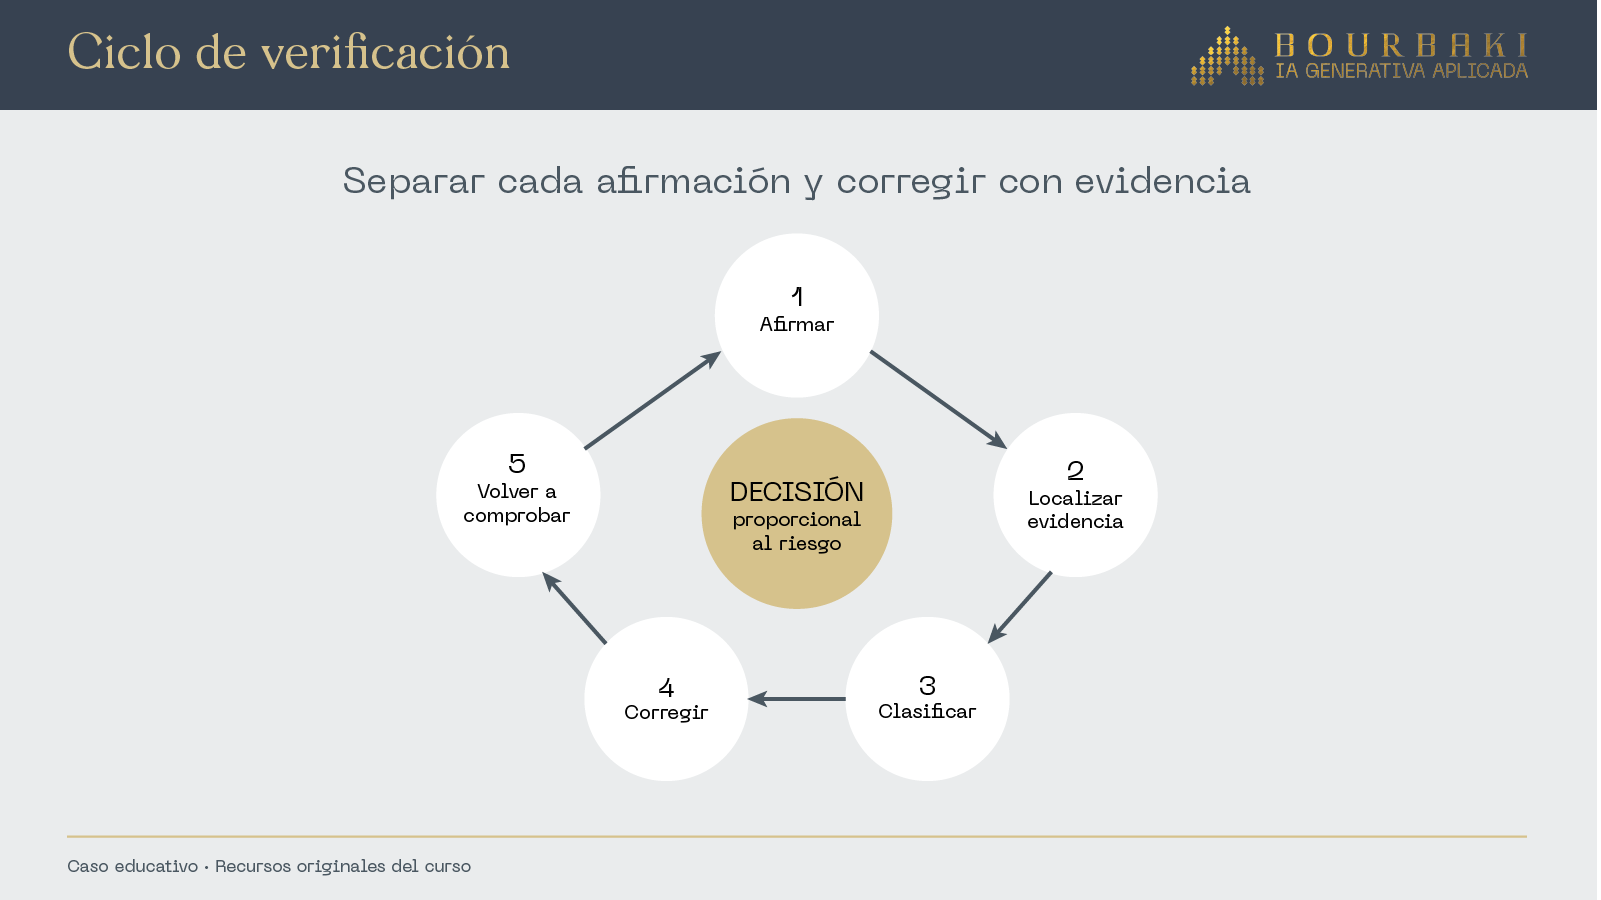
El proceso de verificación consta de cinco acciones:
- separar la respuesta en afirmaciones;
- localizar evidencia para cada afirmación;
- clasificar su estado;
- corregir con la información disponible;
- comprobar nuevamente el resultado.
Video
V4.2. Verificación por afirmaciones — 8 min.
Una alucinación es contenido generado que parece responder a la pregunta, pero es falso o no está respaldado. Puede presentarse como una fecha inventada, una cita inexistente, una cifra sin fuente, una atribución incorrecta o una conclusión más fuerte que la evidencia.
Una demostración exitosa no garantiza un proceso confiable. La estabilidad debe evaluarse mediante varios casos y criterios definidos.
Video
V4.1. Por qué alucina una salida convincente — 8 min.
Un modelo visual puede describir tendencias y leer etiquetas, pero también puede confundir escalas, leyendas o valores pequeños. Antes de aceptar una interpretación conviene identificar el título, el periodo, los ejes, las unidades, la leyenda, los valores visibles y aquello que no puede leerse con confianza.
Video
V3.4. Imágenes y gráficos sin adivinar — 7 min.
Actividad visual
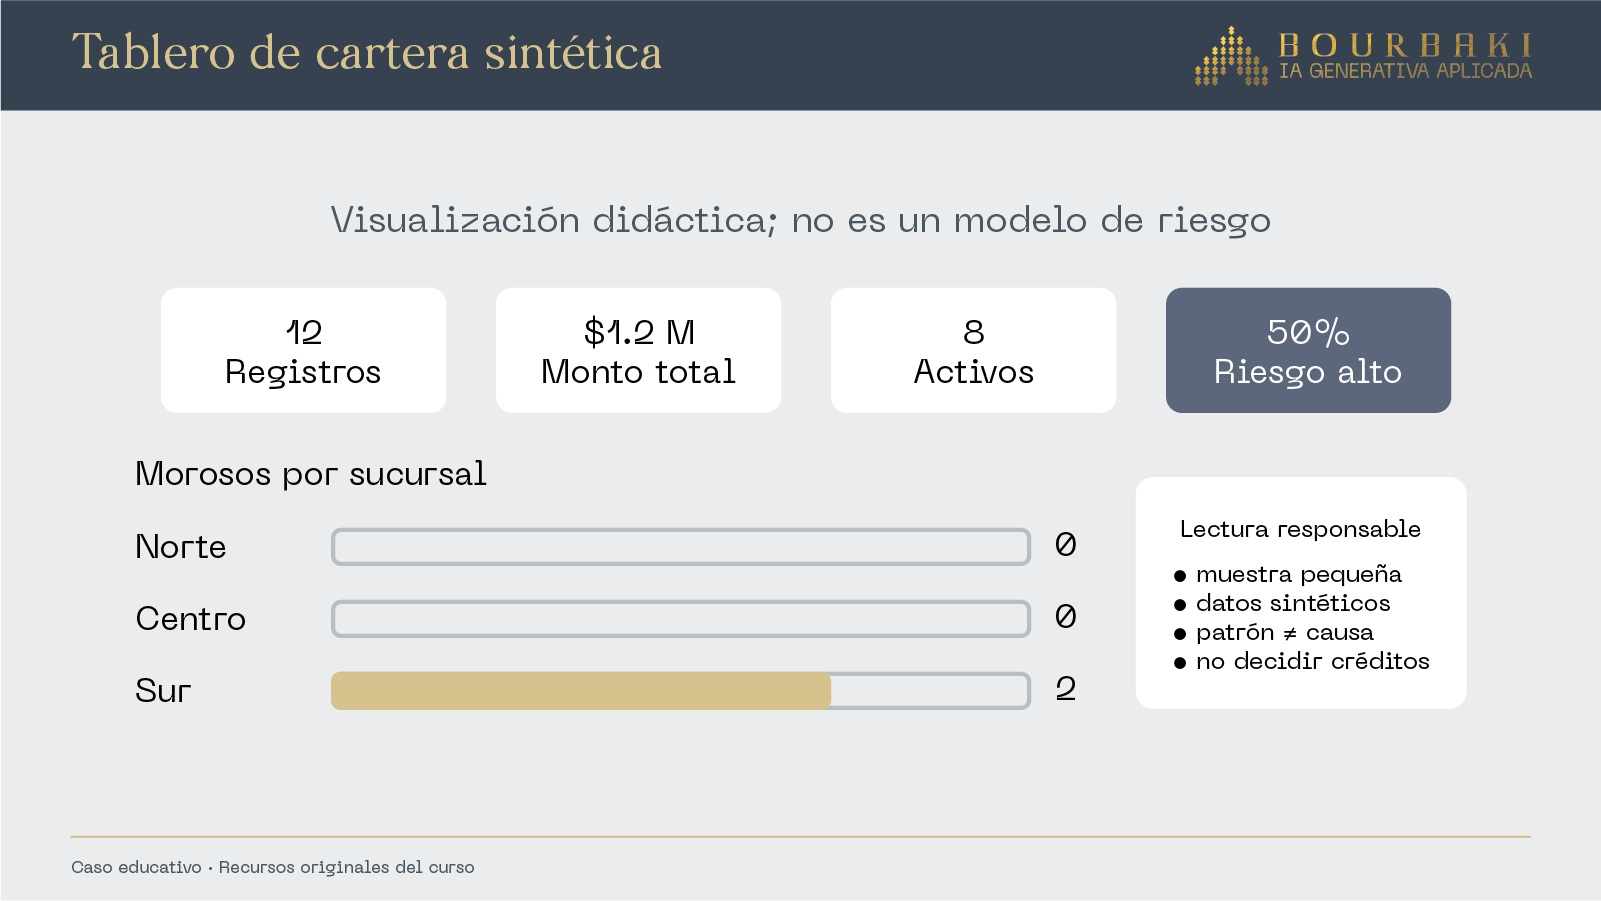
Observar el tablero de cartera y responder qué sucursal presenta morosidad, si el gráfico demuestra sus causas y qué información adicional sería necesaria antes de recomendar una acción.
La calidad de un análisis multimodal depende de la calidad de la extracción. Inventariar, comprobar y reconciliar son parte central del razonamiento.
Comprobación y transferencia
- Knowledge check de seis reactivos — 10 min.
- Identificar un archivo de uso frecuente, sin cargarlo, y anotar qué elementos podrían perderse y qué controles deberían aplicarse.
Antes de solicitar conclusiones sobre una tabla, se deben identificar encabezados, número de registros, tipos de datos, valores faltantes, unidades y formatos de fecha. Toda cifra incluida en un resumen debe poder rastrearse hasta una columna y una operación.
Video
V3.3. Hojas de cálculo: preguntar, comprobar, interpretar — 9 min.
Práctica descargable
Archivo: M03_datos_practica.xlsx
Actividad: inventariar la hoja, calcular controles, crear banderas didácticas y comprobar los resultados de manera independiente.
Solución diferida: M03_solucion_datos.md.
El reconocimiento óptico de caracteres convierte imágenes de texto en caracteres. Puede confundir letras y números, comas y puntos decimales, columnas, firmas, sellos o texto inclinado. Cuando la fidelidad literal importa, la herramienta no debe corregir silenciosamente el documento.
Video
V3.2. Extracción documental con trazabilidad — 8 min.
Práctica descargable
Archivo: M03_minicontrato_sintetico.txt
Entregable: tabla con Campo, Valor extraído, Evidencia literal, Confianza y Revisión necesaria.
Solución diferida: M03_solucion_minicontrato.md.
La herramienta debe convertir el archivo en una representación procesable. Puede extraer texto, reconocer caracteres, leer celdas, describir imágenes o dividir el contenido. Durante este proceso pueden perderse encabezados, tablas, notas al pie, signos, unidades, orden de lectura o relaciones entre cifras y etiquetas.
La secuencia recomendada es:
- inventariar el archivo;
- extraer los campos necesarios;
- comprobar muestras, unidades y totales;
- analizar únicamente cuando la representación sea suficiente.
Video
V3.1. Qué ocurre cuando cargas un archivo — 8 min.

En tareas complejas conviene solicitar productos que una persona pueda revisar: supuestos, fórmulas, evidencia, cálculos con unidades, datos faltantes, incertidumbres y una justificación breve. No es necesario pedir que el modelo exponga toda su cadena interna de razonamiento.
Video
V2.5. Razonamiento sin pedir cadena de pensamiento — 8 min.
Prácticas del módulo
- Clasificación con ejemplos: crear primero una versión zero-shot y después añadir un ejemplo únicamente si mejora el formato o aclara los límites.
- Correo ejecutivo: construir un prompt MARCO para redactar un correo de máximo 140 palabras con cifras verificadas.
- Taller de plantilla reutilizable: probar la misma plantilla con una entrada completa y otra incompleta.
Un buen prompt no obliga al modelo a adivinar qué significa “bien”. MARCO convierte una intención en un resultado que puede revisarse, repetirse y mejorar.
Una instrucción como “hazlo mejor” no explica qué debe cambiar. Para iterar de forma útil:
- genera una primera versión;
- evalúala con una lista de criterios;
- identifica el defecto de mayor impacto;
- solicita un cambio localizado;
- comprueba nuevamente el resultado.
Las tareas recurrentes pueden convertirse en plantillas al separar las partes fijas de los datos variables.
Video
V2.4. Iteración y plantillas — 8 min.
Archivo: M02_plantilla_MARCO.md
Antes de enviar una instrucción, revisa:
- si la meta describe una acción observable;
- si los datos están delimitados;
- si las reglas resuelven casos ambiguos;
- si el formato permite comprobar que nada falta;
- si existe un criterio de éxito independiente del estilo de redacción.
Cuando falte información, la respuesta debe señalarlo en lugar de inventarla. Puede agregarse una sección final de Comprobaciones con criterios cumplidos, supuestos y puntos que requieren revisión humana.
Video
V2.3. Del prompt vago al verificable — 8 min.
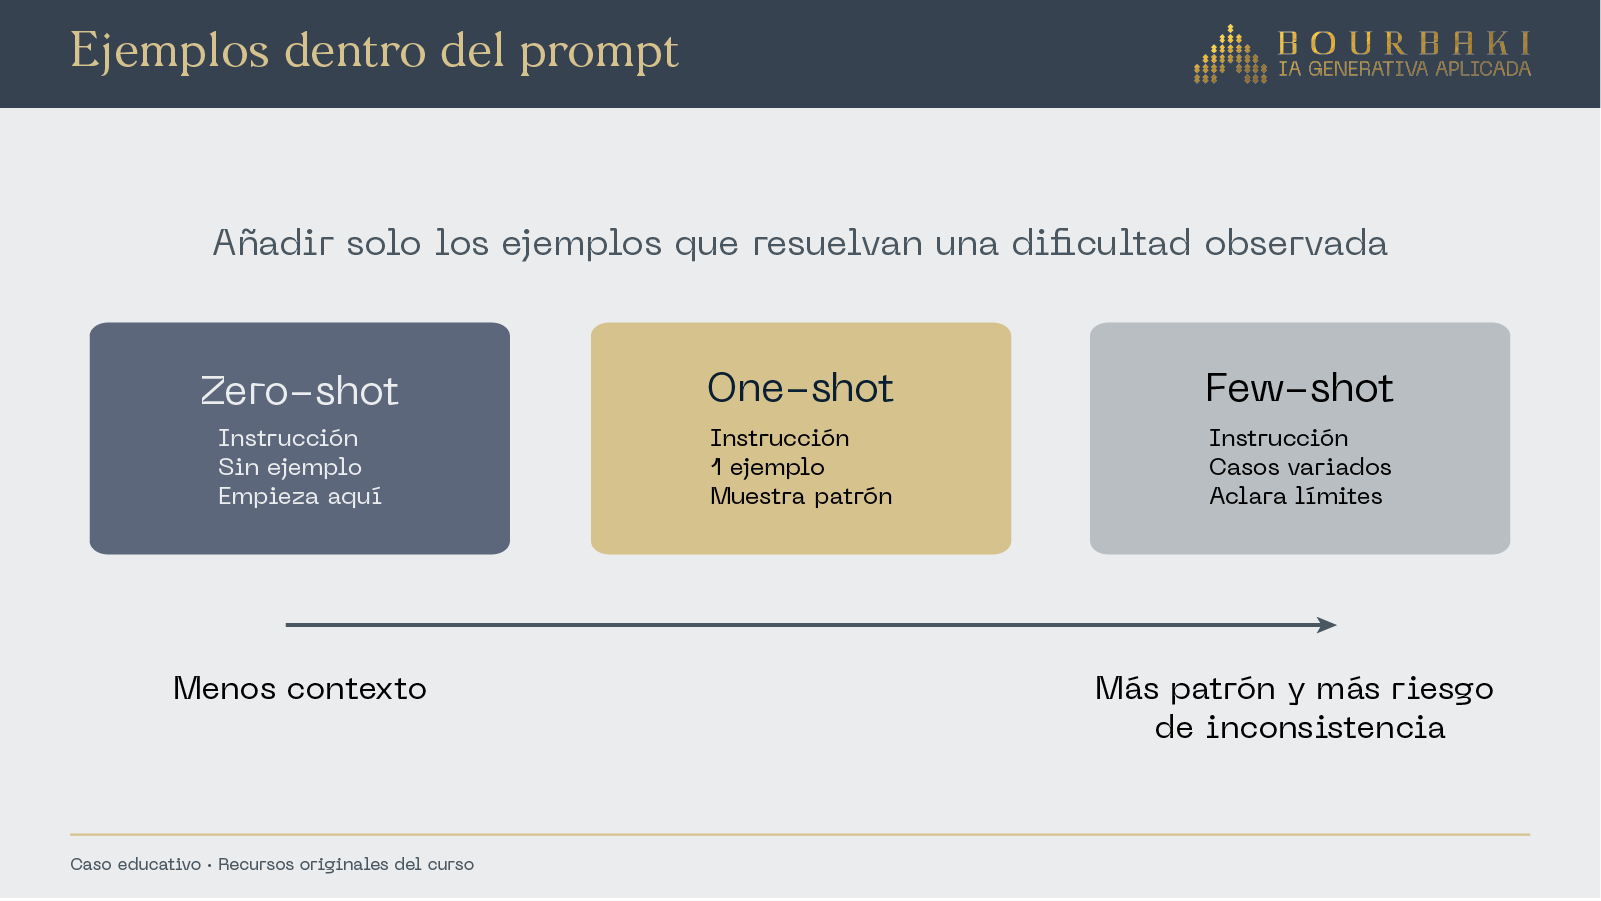
- Zero-shot: la instrucción no contiene ejemplos; es el punto de partida cuando la tarea y el formato son claros.
- One-shot: se incluye un ejemplo de entrada y salida para mostrar un patrón.
- Few-shot: se incluyen varios ejemplos para representar casos variados o límites de una clasificación.
Más ejemplos no siempre producen una mejor respuesta. Cada ejemplo debe ser consistente con las reglas y con el formato solicitado.
Video
V2.2. Zero-, one- y few-shot — 7 min.
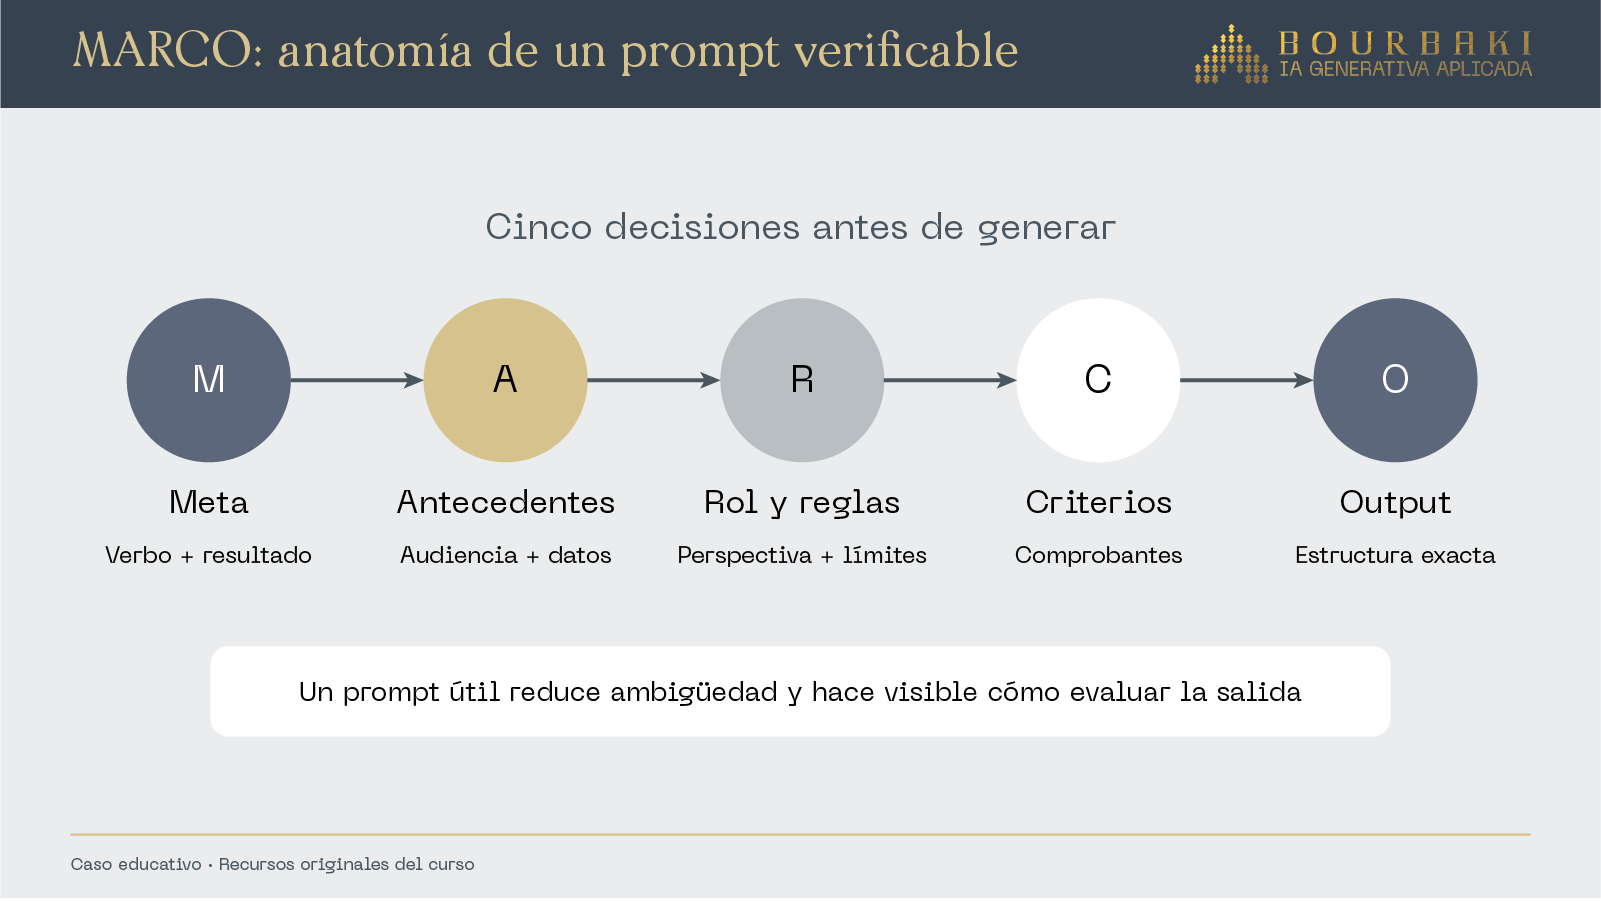
Un prompt útil se parece a una especificación breve. El método MARCO reúne cinco decisiones:
- M — Meta: verbo observable y resultado esperado.
- A — Antecedentes: audiencia, situación y datos relevantes.
- R — Rol y reglas: perspectiva útil, límites y prohibiciones.
- C — Criterios de éxito: condiciones que permiten comprobar la calidad.
- O — Output: estructura exacta de la respuesta.
Video
V2.1. El método MARCO — 9 min.
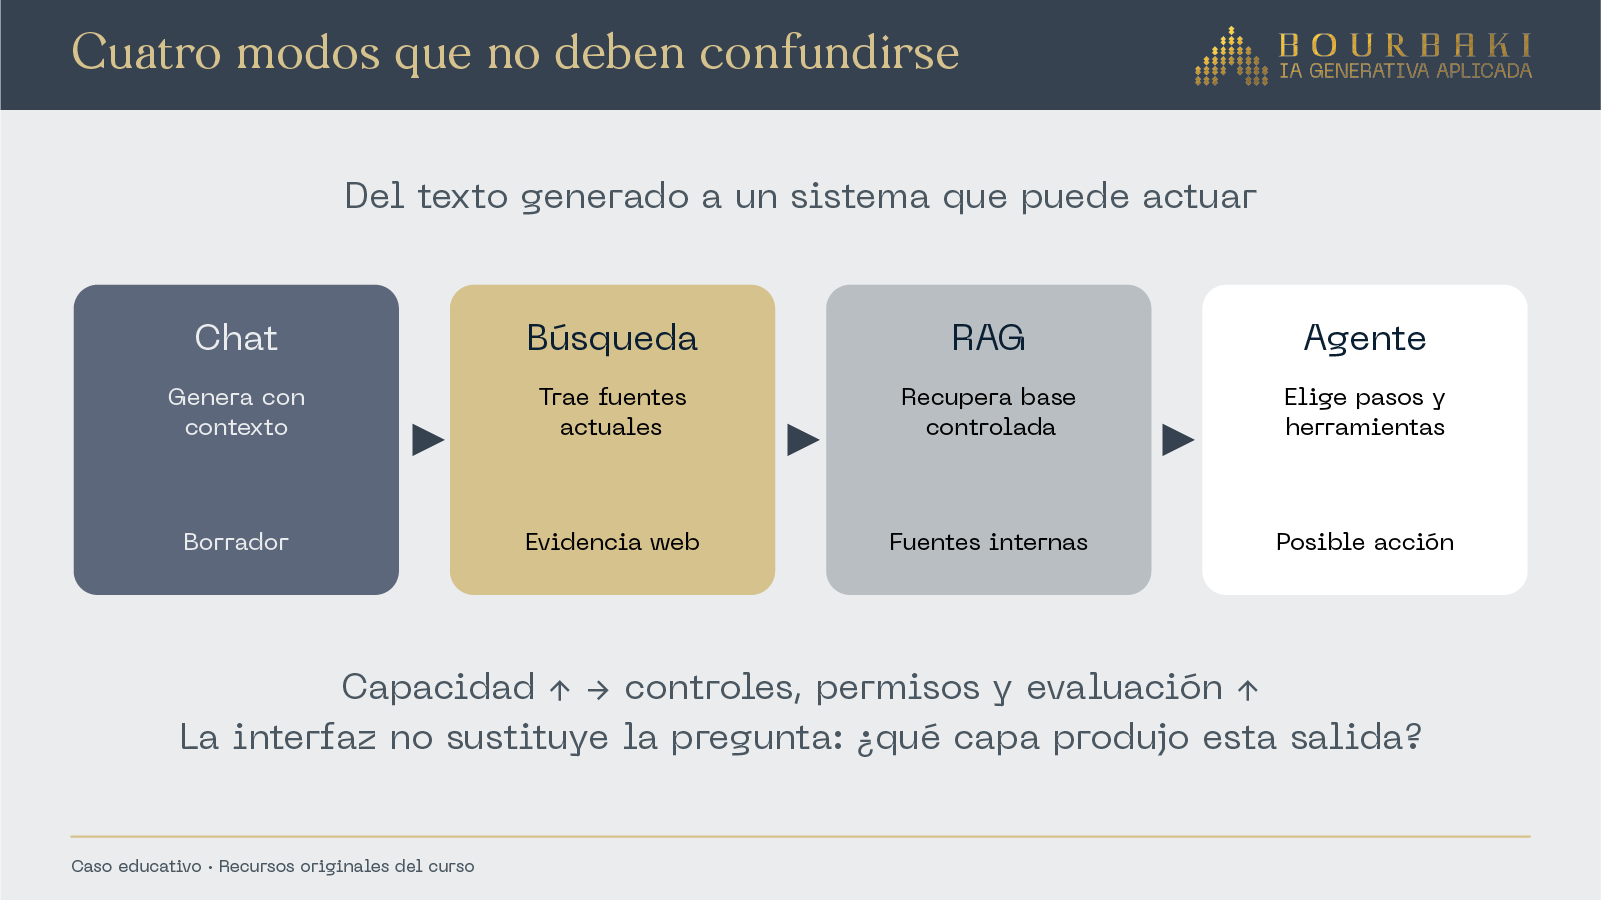
- Chat: transforma, resume, redacta o explica a partir del contexto disponible.
- Búsqueda: localiza información actual y fuentes verificables.
- Trabajo con archivos: responde con base en documentos seleccionados.
- RAG: recupera fragmentos pertinentes de una colección amplia antes de responder.
- Agente: persigue un objetivo mediante varios pasos y puede utilizar herramientas o preparar acciones.
A mayor capacidad de actuar, mayor necesidad de permisos, registros, límites y aprobación humana.
Video
V1.4. Cinco confusiones que debes evitar — 7 min.
Práctica del módulo
La herramienta mínima suficiente
El participante deberá elegir entre chat, búsqueda, fuentes, RAG o agente para cinco tareas y registrar una razón y un riesgo en cada caso:
- Cambiar un comunicado técnico a lenguaje ciudadano.
- Confirmar una tasa de referencia vigente.
- Contestar preguntas sobre tres políticas internas.
- Consultar una colección de diez mil manuales y reportes.
- Recibir una solicitud, consultar reglas, preparar una recomendación y enviarla después de aprobación.
Cierre para la plataforma
Un modelo generativo es una herramienta flexible de transformación y generación, no una autoridad. Elegir la modalidad adecuada es la primera decisión de calidad y seguridad.
Un token es una unidad que procesa el modelo. Puede ser una palabra completa, una parte de una palabra o un signo. La ventana de contexto es la cantidad de información que el sistema puede considerar durante una interacción.
Cuando el material es extenso, algunos fragmentos pueden quedar fuera o recibir menor atención. Para reducir este riesgo conviene separar instrucciones, datos y ejemplos; hacer visibles las reglas importantes y dividir las tareas complejas en productos intermedios comprobables.
Los sistemas de lenguaje han evolucionado desde reglas escritas manualmente y patrones estadísticos hasta representaciones vectoriales, mecanismos de atención y herramientas capaces de consultar fuentes o ejecutar funciones. Esta evolución explica capacidades distintas; no debe presentarse únicamente como una lista de marcas o productos.
Video
V1.2. Una historia útil, sin convertirla en museo — 8 min.

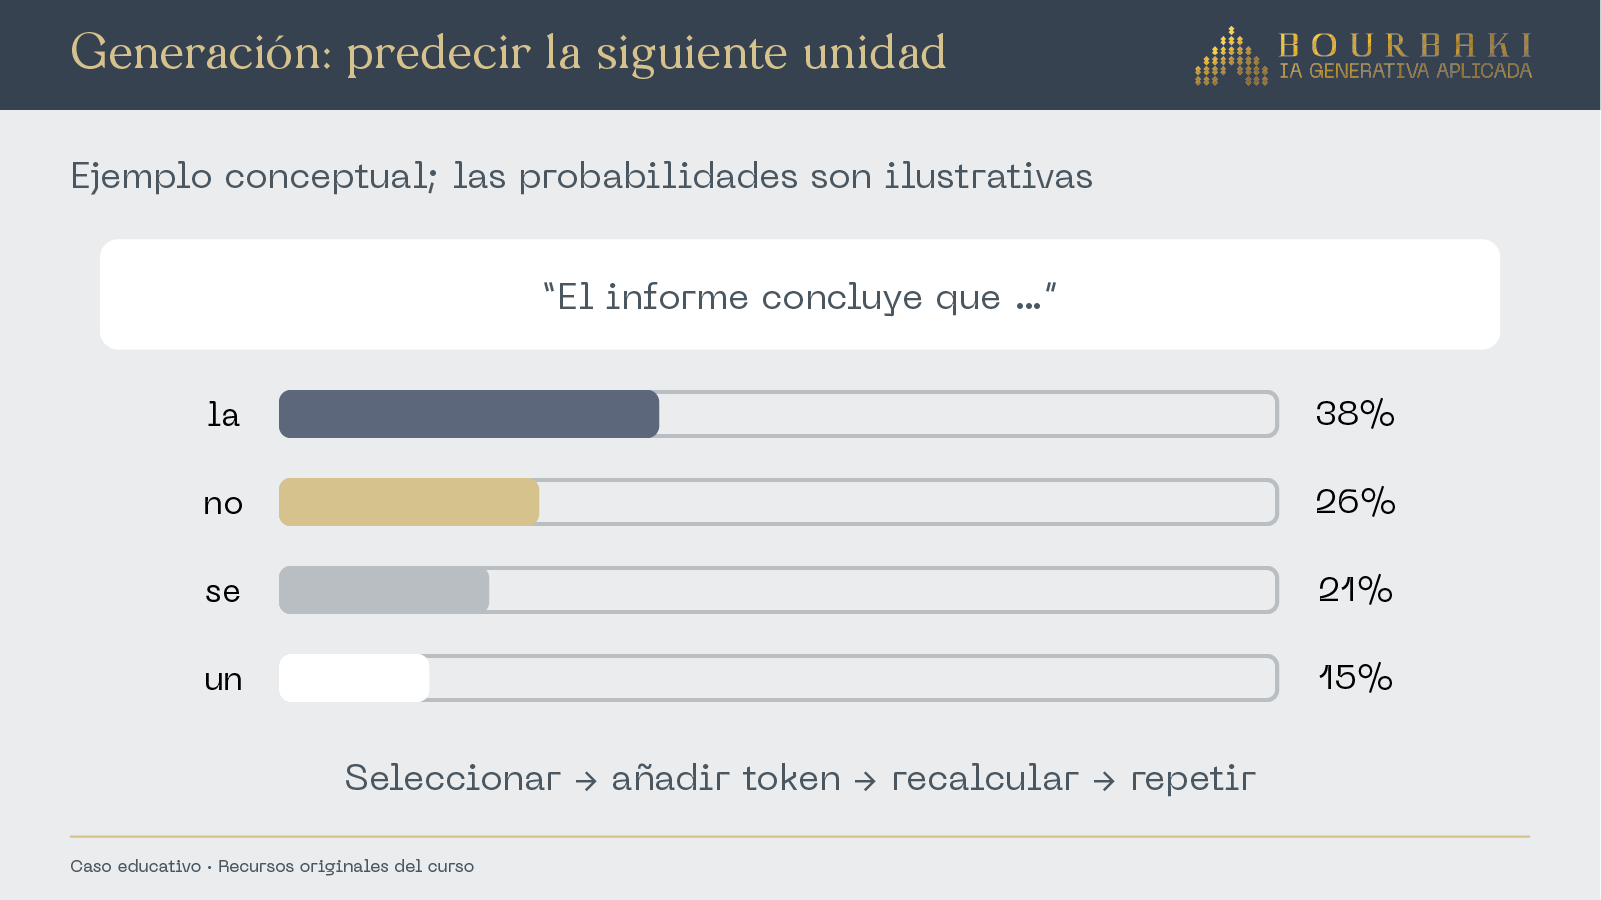
Un modelo del lenguaje recibe una secuencia de unidades de texto y calcula qué continuación resulta plausible. Repite este proceso muchas veces hasta formar una respuesta. La fluidez proviene de patrones aprendidos a gran escala, pero no demuestra que cada afirmación haya sido verificada.
Por ello, la pregunta útil no es solamente “¿la IA sabe esto?”, sino “¿qué información tuvo disponible y cómo puedo comprobar su respuesta?”.
Video
V1.1. Qué genera un modelo de lenguaje — 7 min.
Actividad interactiva
Presentar varias frases incompletas para que el participante elija o proponga continuaciones posibles. La retroalimentación debe explicar que pueden existir varias continuaciones plausibles y que el contexto modifica su probabilidad.
Actividades
- Ver el video V0.1. Bienvenida y contrato de aprendizaje — 5 min.
- Registrar una meta personal de aprendizaje.
- Aceptar el acuerdo de uso responsable.
- Contestar el diagnóstico inicial de diez reactivos, sin calificación.
Evaluación Diagnostica
No cargues información personal, confidencial, credenciales ni archivos reales de tu organización. Todas las prácticas del curso utilizan datos sintéticos. En situaciones laborales, consulta siempre las políticas institucionales y utiliza únicamente herramientas autorizadas.